1. Introduzione: Il dilemma dell’efficienza e il nuovo salto dell’IA
Per ingegneri del software, ricercatori e tech leader, l’adozione degli agenti IA ha da sempre comportato un duro compromesso: scegliere tra la velocità operativa, il controllo dei costi computazionali e la capacità di eseguire task complessi a lungo termine senza che il modello deragli. Quando si affrontano progetti imponenti — come la migrazione integrale di una codebase aziendale o la formalizzazione di complesse dimostrazioni scientifiche — i modelli di precedente generazione tendevano a bloccarsi, a esaurire la finestra di contesto o ad accumulare errori logici a cascata.
Il 9 novembre 2026, Anthropic ha annunciato ufficialmente Claude Fable 5.2 e Claude Mythos 5.2, segnando un passaggio fondamentale nell’evoluzione dell’intelligenza artificiale autonoma su lungo orizzonte (long-horizon agentic work).
Entrambi i modelli condividono lo stesso motore architetturale di base:
- Finestra di contesto: 1 milione di token.
- Output massimo: 128K token per singolo turno.
- Cutoff di conoscenza: Giugno 2026.
La differenza sostanziale risiede nella gestione delle salvaguardie: mentre Fable 5.2 è accessibile al pubblico ed è provvisto di filtri attivi contro i rischi cibernetici e biologici, Mythos 5.2 è destinato esclusivamente ad organizzazioni verificate per la ricerca avanzata.
L’aspetto davvero rivoluzionario di questa release non risiede soltanto nei nuovi record registrati sui benchmark, ma nel fatto che Fable 5.2 stravolge l’equazione economica dell’IA agentica: offre prestazioni superiori, riduce i costi di listino del 20% ed esegue task autonomi di decine di ore a una frazione dello sforzo computazionale precedente.
2. Formalizza la dimostrazione del Teorema di Fermat: La svolta del ragionamento agentico a lungo termine
Per dimostrare le capacità esecutive a lungo termine di Fable 5.2, Anthropic ha messo alla prova il modello su uno dei rompicapi matematici più celebri della storia: l’Ultimo Teorema di Fermat. Formulato da Pierre de Fermat nel 1637 e dimostrato da Andrew Wiles negli anni ’90 attraverso oltre 100 pagine di teoria dei numeri avanzata, il teorema è stato al centro di un imponente progetto comunitario avviato nel 2024 dal matematico Kevin Buzzard per la sua formalizzazione nell’assistente di dimostrazione Lean.
Un team di agenti Fable 5.2 ha completato la formalizzazione dell’intera dimostrazione dell’Ultimo Teorema di Fermat in Lean in sole 30 ore, con un intervento umano minimo. A titolo di confronto, uno sforzo analogo condotto da Anthropic a settembre 2026 con un modello di ricerca interno (paragonabile a Fable 5.1) aveva richiesto 11 giorni e circa sei miliardi di token di output.
Il confronto diretto con il modello top di gamma per il lavoro quotidiano evidenzia un netto divario sulle lunghe distanze:
“Nella stessa configurazione Lean con 1.000 agenti, Opus 5.5 ha completato il 26% della dimostrazione dell’Ultimo Teorema di Fermat in 18 ore e ha fatto pochissimi progressi dopo. Fable 5.2 ha completato tutto in 30 ore.”
Il valore tecnico (e le dovute precisazioni)
Perché la formalizzazione meccanica è un benchmark così rigoroso per gli agenti IA? A differenza delle risposte in linguaggio naturale, le dimostrazioni formali in Lean non permettono allucinazioni: il codice o compila perfettamente verificando ogni passaggio fino agli assiomi di base, oppure fallisce. Fable 5.2 ha dimostrato di saper mantenere la coerenza logica lungo un arco temporale prolungato senza rimanere bloccato in loop infruttuosi.
Per un’analisi intellettualmente onesta, vanno tuttavia sottolineate due sfumature fondamentali riprese dalla comunità scientifica:
- Nessuna nuova matematica: La formalizzazione in Lean non ha “scoperto” nuovi teoremi, ma ha tradotto una dimostrazione umana preesistente in codice verificabile dalla macchina.
- Roadmap guidata: Agli agenti Fable 5.2 è stato fornito un elenco preparato di enunciati di teoremi intermedi per monitorare i progressi. Gli agenti dovevano capire come dimostrare ciascun passaggio, ma la mappa generale era tracciata.
Dalla teoria alla produzione industriale
Questa autonomia esecutiva si traduce direttamente in casi d’uso concreti per il mondo engineering:
- Migrazione di codice legacy: Agenti basati su Fable 5.2 hanno migrato un intero servizio aziendale da Python a Rust, ottenendo un tempo di avvio circa 26 volte più rapido.
- Ricerca scientifica applicata: Il modello ha risolto 2 problemi aperti nella fisica dei buchi neri, la cui soluzione è stata pubblicata sotto forma di preprint scientifici.
- Progettazione hardware: Fable 5.2 ha progettato da zero 3 dispositivi elettronici perfettamente funzionanti.
3. Prestazioni da top di gamma con un taglio del prezzo del 20% (E il trucco dello “Sforzo Basso”)
Insieme ai salti prestazionali, Fable 5.2 ridefinisce la sostenibilità economica dei workflow agentici. Rispetto a Fable 5.1, Anthropic ha ridotto i prezzi del 20% su tutte le voci dell’API (input, output, scritture/letture cache e batch processing).
Confronto Strutturato dei Costi (in USD per 1M di Token)
| Voce di Costo | Claude Fable 5.2 | Claude Fable 5.1 | Claude Opus 5.5 |
| Input Base | $8.00 | $10.00 | $4.00 |
| Output Base | $40.00 | $50.00 | $20.00 |
| Letture Cache | $0.20 (Sconto 97,5%) | $0.25 | $0.20 |
| Scritture Cache (5 min) | $10.00 | $12.50 | $5.00 |
| Batch Processing (Input / Output) | $4.00 / $20.00 | $5.00 / $25.00 | $2.00 / $10.00 |
| Fast Mode (Input / Output) | $16.00 / $80.00 | Non disponibile | $8.00 / $40.00 |
Anthropic non ha annunciato una data di ritiro immediata per Fable 5.1. Tuttavia, per i nuovi progetti Fable 5.1 è da considerarsi di fatto superato. I team con prompt e agenti fortemente ottimizzati su 5.1 dovrebbero effettuare benchmark comparativi prima di disattivare i vecchi workflow.
Velocità e reattività
Fable 5.2 genera token di output fino al 30% più velocemente rispetto a Fable 5.1. Per le applicazioni in cui la latenza di risposta è prioritaria, la nuova Fast Mode accelera la generazione dell’output fino a 2,5 volte rispetto allo standard (al costo di $16.00 input / $80.00 output).
L’impatto chiave delle letture cache e del parametro “Effort”
Il vero punto di svolta economico risiede in due fattori legati all’architettura degli agenti:
- **Prompt Caching Scontato (0.20/1M token):** Il costo delle letture da cache rappresenta un risparmio del **97,5%** rispetto all’input base (8.00). Per i loop agentici che reinviano continuativamente lo storico della conversazione e del contesto, l’impatto sui costi totali è devastante in senso positivo.
- Efficienza tramite il parametro Effort (Sforzo):
- Sforzo Basso (Low Effort): Su Humanity’s Last Exam (con strumenti), Fable 5.2 a sforzo basso eguaglia il miglior punteggio di Opus 5.5 a meno di un decimo del costo per task.
- Sforzo Alto (High Effort): Sul benchmark di agentic coding FrontierCode 2.0, Fable 5.2 a sforzo alto ottiene il 45.3% (eguagliando il punteggio massimo di Opus 5.5) a circa la metà del costo per task.
Consiglio di ottimizzazione per sviluppatori: Se state effettuando il passaggio da Claude Opus 5.5 a Fable 5.2, non impostate immediatamente il parametro effort al livello massimo (max). Iniziate i test con livelli di sforzo inferiori: otterrete le medesime prestazioni di Opus 5.5 consumando una quota nettamente inferiore di token di ragionamento.
4. Dominio quasi assoluto nei Benchmark (con un’unica sorpresa)
La tabella dei benchmark ufficiali Anthropic mostra un netto progresso generazionale rispetto a Fable 5.1 (rilasciato a settembre 2026), posizionando Fable 5.2 davanti a concorrenti quali GPT-6 Astra e Gemini 4 Carbon nella quasi totalità dei test.
Sintesi delle metriche di performance:
- Agentic Coding:
- FrontierCode 2.0: Fable 5.2 al massimo sforzo raggiunge il 49.1% (rispetto al 45.3% ottenuto ad alto sforzo, al 32.4% di Fable 5.1, al 45.5% di Opus 5.5 e al 42.8% di GPT-6 Astra).
- FrontierSWE v2: Domina la classifica con il 69.9% (contro il 65.5% di GPT-6 Astra e il 62.3% di Opus 5.5).
- Knowledge Work & Ricerca Scientifica:
- Remote Labor Index: Raggiunge il 41.3%, raddoppiando le prestazioni di Opus 5.5 (21.3%) e GPT-6 Astra (20.8%).
- Humanity’s Last Exam (con strumenti): Segna il 74.2% (vs 67.7% di Opus 5.5).
- Terminal-Bench-Science 0.1: Fable 5.2 tocca il 74.6%, mentre la variante Mythos 5.2 raggiunge il 75.3%.
- Computer Use, Visione e Robotica:
- OSWorld 2.1 (Computer Use): Raggiunge l’89.3% (vs 87.2% di Opus 5.5 e 79.5% di GPT-6 Astra).
- RoboDojo Sim (Robotica): Mostra un balzo dal 27.6% (Fable 5.1) al 64.9%.
- BenchCAD 2.1 (Hardware Design): Totalizza 83.5 punti (contro 65.3 di Opus 5.5).
- Chartography (Visione senza strumenti): Registra il 73.4% (rispetto al 44.8% di Fable 5.1).
   REMOTE LABOR INDEX (Progetti Freelance Reali)
   -------------------------------------------------
   Fable 5.2     ██████████████████████ 41.3%
   Opus 5.5      ███████████ 21.3%
   GPT-6 Astra   ███████████ 20.8%
   Fable 5.1     ███████ 17.9%
   -------------------------------------------------
L’eccezione: AutomationBench
L’unico benchmark in cui Fable 5.2 non si attesta in cima alla classifica è AutomationBench (che valuta i workflow aziendali automatizzati). In questo contesto, Gemini 4 Carbon mantiene il primato con il 53.9%, contro il 51.4% di Fable 5.2 (comunque in crescita rispetto al 31.4% di Fable 5.1).
5. Fable 5.2 vs. Mythos 5.2: Stessa intelligenza, diversa sicurezza e politica dei dati
Anthropic ha strutturato la release separando il modello in base alle esigenze d’uso e ai requisiti di sicurezza:
- Claude Fable 5.2: Modello pubblico dotato di salvaguardie che limitano la generazione di exploit cibernetici e la ricerca biologica a duplice uso.
- Claude Mythos 5.2: Condivide la medesima architettura e potenza di ragionamento di Fable 5.2, ma è privo dei blocchi sulle attività di sicurezza informatica e biologia avanzata. È accessibile esclusivamente alle organizzazioni accreditate tramite il Cyber Verification Program e il Life Sciences Verification Program. Nei test dedicati, Mythos 5.2 registra il 76.3% su CyScenarioBench, l’89.6% su CVE Rediscovery e l’85.1% nella progettazione di leganti proteici.
Riduzione dei falsi positivi (Refusals)
Un miglioramento rilevante per l’operatività quotidiana riguarda la riduzione dei blocchi ingiustificati: Fable 5.2 registra circa il 55% di blocchi di sicurezza in meno rispetto a Fable 5.1 (con una riduzione del 60% nei rifiuti legati alla cybersecurity e del 40% nella biologia). Il modello rifiuta con molta meno frequenza le analisi di sicurezza legittime, mantenendo i blocchi su penetration testing malevolo ed exploit generation.
Data Retention e Sicurezza Enterprise
- Politica di Conservazione dei Dati: Entrambi i modelli richiedono una retention obbligatoria dei dati di 30 giorni per consentire i controlli di sicurezza automatizzati. Le aziende che necessitano di Zero Data Retention (ZDR) devono avvalersi delle Enterprise Frontier Safeguards, una modalità che esegue i controlli di monitoraggio di Anthropic direttamente all’interno dell’infrastruttura cloud del cliente.
- Allineamento e Trasparenza: In un audit comportamentale su 1.900 scenari, il modello ha fatto registrare i punteggi di disallineamento più bassi mai rilevati nei test Anthropic. Sia Fable 5.2 che Mythos 5.2 mostrano un’elevata evaluation awareness (consapevolezza di essere sotto test).
- Protezione Anti-Distillazione e Preserved Thinking: È stato implementato il controllo obbligatorio del prefisso (prefix check): se il codice dell’applicazione modifica il prompt di sistema, gli strumenti o i messaggi precedenti e rinvia all’API un blocco di ragionamento (thinking block) generato in un turno successivo, l’API restituisce un errore 400, impedendo la manipolazione dei blocchi di pensiero.
6. Offerte di Lancio, Reset dei Limiti e Guida alla Scelta del Modello
Per accompagnare il lancio del 9 novembre 2026, Anthropic ha introdotto promozioni dedicate e un sistema di reset dei limiti di utilizzo per gli abbonati ai piani a pagamento.
Promozioni di Lancio
- Piani Pro e Postazioni Team Standard: Tutti i modelli Fable sono inclusi nel piano dal 9 al 16 novembre 2026 (fino al 50% dei limiti di utilizzo settimanali). Gli account idonei ricevono inoltre 1 reset gratuito dei limiti Fable (da riscattare entro il 16 novembre 2026).
- Piani Max, Ultra, Team Premium ed Enterprise Premium: Ricevono da 1 a 3 reset dei limiti Fable in base all’anzianità dell’abbonamento continuativo (misurata dalla prima fattura saldata):
- Meno di 6 mesi: 1 Reset
- Da 6 a 12 mesi: 2 Reset
- Oltre 12 mesi: 3 Reset (I reset possono essere attivati in Settings > Usage e scadono l’8 marzo 2027).
Come funziona un Fable Limit Reset? Il reset ripristina la quota spesa sui modelli Fable all’interno del limite settimanale (lasciando inalterato il consumo sugli altri modelli Claude). Se l’account include una finestra limite di 5 ore, quest’ultima viene interamente ricaricata.
Guida Strategica alla Scelta del Modello
L’adozione dei modelli nell’ecosistema Claude può essere schematizzata secondo l’albero decisionale seguente:
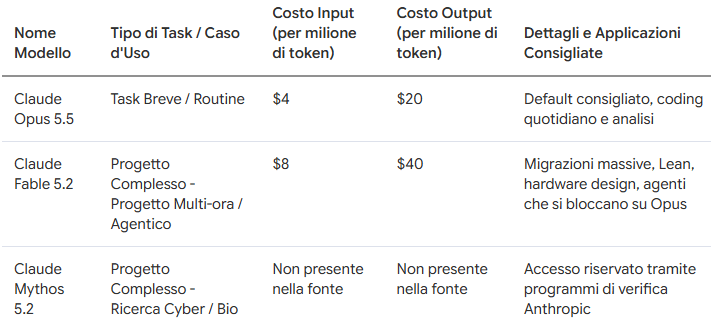
- Claude Opus 5.5 ($4 / $20): Il default consigliato. Costa la metà per token ed è la scelta d’elezione per lo sviluppo quotidiano e i task a breve orizzonte.
- Claude Fable 5.2 ($8 / $40): Da utilizzare per compiti complessi, loop multi-agente di molte ore, migrazioni infrastrutturali o quando Opus 5.5 s’interrompe senza completare il task. (Disponibile via API con l’ID
claude-fable-5-2, sulle app Claude e su piattaforme cloud AWS Bedrock, Google Cloud e Microsoft Foundry). - Claude Mythos 5.2: Riservato a team di cybersecurity e ricerca biomedica accreditati.
- Claude Sonnet 5.5 / Haiku 5.5: Indicati per volumi elevati, task semplici, workflow sensibili alla latenza o come sotto-agenti guidati da Fable 5.2.
7. Conclusione: Il futuro dell’autonomia agentica e la sfida dell’efficienza
L’uscita di Claude Fable 5.2 indica una direzione chiara per lo sviluppo dei modelli di intelligenza artificiale: il fattore determinante non è più soltanto la risposta al singolo prompt, ma la capacità di un agente di operare in autonomia su progetti di ampio respiro. Riuscendo a ridurre i costi del 20% e ad accelerare la generazione dei token rispetto alla versione 5.1, Anthropic dimostra che le prestazioni di vertice possono integrarsi in architetture economicamente sostenibili.
La peculiarità di Fable 5.2 sta nel passaggio dal micro-management passo-passo alla delega di workflow agentici complessi — come evidenziato dalla dimostrazione in Lean o dalle migrazioni software da Python a Rust — in cui il modello lavora per decine di ore consecutive mantenendo la coerenza logica.
Mentre Opus 5.5 rimane la scelta primaria ed economica per l’operatività di tutti i giorni, Fable 5.2 si posiziona come il motore di riferimento per l’automazione autonoma ad altissima complessità.
Fonti
https://www.datacamp.com/it/blog/claude-fable-5-2-and-mythos-5-2
https://support.claude.com/en/articles/17506494-claude-fable-5-2-launch-offers
https://platform.claude.com/docs/en/release-notes/overview
https://www.anthropic.com/claude-fable-and-mythos-5-2
https://aws.amazon.com/it/blogs/machine-learning/introducing-claude-fable-5-2-on-aws
https://claude.com/it/resources/articles/introduction-to-agentic-coding